Rastreo de Actividad en Clash of Clans con Dataform y BigQuery
Antes de empezar, recuerda que es la tercera publicación relacionada a este proyecto, por lo que te recomiendo visitar los siguientes enlaces antes de empezar aquí:
- https://josechavez.net/analysis/robust-elt-pipeline/
- https://josechavez.net/analysis/data-transformation-dataform/
Voy a darle un enfoque diferente a esta publicación, pues quiero que nos empapemos del rol de creadores de métricas. Para esto, utilizaré el proyecto de Clash of Clans cómo un punto de partida. Muy bien, iniciamos nuestra rutina y el líder del clan (o nuestro jefe) nos pide determinar quiénes son los miembros activos, para gestionar ascensos o expulsiones. Por lo que, se nos asigna la tarea de reportarle diariamente estos datos para que vaya decidiendo en base a información actualizada, cada mañana mientras bebe su café.
¿Dónde empezamos?
Lo principal es asegurarnos de tener alineación conceptual. El líder nos pidió determinar quiénes son los miembros activos, pero ¿qué implica ser activo? Luego de tener una reunión con el líder y preguntarle nos dice lo siguiente: Un miembro activo es aquel que durante los últimos 7 días realizó una de las siguientes acciones:
- Atacó en alguna guerra.
- Actualizó su Ayuntamiento.
- Subió de nivel a algún héroe.
- Subió de nivel alguna habilidad de héroe.
- Subió de nivel un hechizo.
- Contribuyó en los asaltos de la capital.
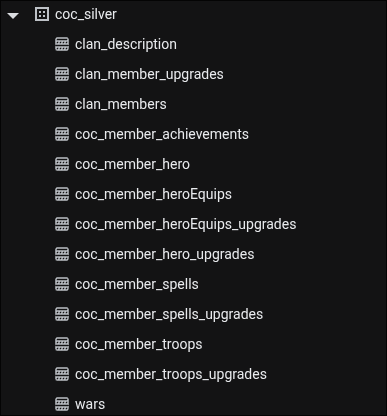
Afortunadamente, tenemos la información histórica en el pipeline que diseñamos, solo debemos escribir la lógica y responder a la pregunta de negocio. Cómo somos visionarios, propusimos crear un indicador consolidado de “actividad”, este va añadiendo cuántos criterios cumple cada miembro, para ordenarlos en un ranking. Las tablas que utilizaremos son las siguientes:
¿Cómo armamos la tabla?
En realidad serán dos tablas, una histórica (porque sabemos que es posible que queramos contrastar las variaciones entre actividad de miembros en el futuro) y una que contiene información del último corte, es decir, una hot table que se recrea cada día y esta pensada para ser ingerida con un costo bajo.
Esta tabla histórica es representada en la siguiente definición de dataform:
config {
  type: "incremental",
  schema: "coc_gold",
  uniqueKey: ["generated_at", "ptag"],
  description: "Historical daily partition snapshot tracking member activity scores calculated across all upgrade dimensions.",
  tags: ["gold", "daily", "activity"],
  bigquery: {
    partitionBy: "DATE(generated_at)",
    clusterBy: ["ptag", "activity"],
    labels: {
      environment: "production",
      domain: "clash-of-clans",
      layer: "gold"
    }
  },
  assertions: {
    uniqueKey: ["generated_at", "ptag"],
    nonNull: ["generated_at", "ptag", "activity"]
  },
  columns: {
    generated_at: "Deterministic execution timestamp when this snapshot partition was generated.",
    ptag: "Unique player tag identifier.",
    wars_active: "Indicator (1/0) if player participated in war stars progression.",
    capital_active: "Indicator (1/0) if player contributed to clan capital.",
    th_active: "Indicator (1/0) if player upgraded town hall.",
    upgrade_hero: "Indicator (1/0) if player upgraded any hero.",
    upgrade_spell: "Indicator (1/0) if player upgraded any spell.",
    upgrade_troop: "Indicator (1/0) if player upgraded any troop.",
    upgrade_heroEquip: "Indicator (1/0) if player upgraded any hero equipment.",
    activity: "Aggregated activity score (sum of all 7 activity indicators, range 0-7)."
  }
}

js {
  const execution_ts = dataform.projectConfig.vars.execution_timestamp || "2026-08-02T12:00:00Z";
}

WITH unified_metrics AS (
  SELECT
    ptag,
    CASE WHEN war_stars_var > 0 THEN 1 ELSE 0 END AS wars_active,
    CASE WHEN capital_contrib_var > 0 THEN 1 ELSE 0 END AS capital_active,
    CASE WHEN thl_var > 0 THEN 1 ELSE 0 END AS th_active,
    0 AS upgrade_hero,
    0 AS upgrade_spell,
    0 AS upgrade_troop,
    0 AS upgrade_heroEquip
  FROM ${ref("clan_member_upgrades")}
  WHERE extracted_date BETWEEN DATE_SUB(DATE('${execution_ts}'), INTERVAL 7 DAY) AND DATE('${execution_ts}')

  UNION ALL

  SELECT
    ptag, 0, 0, 0,
    CASE WHEN level_var > 0 THEN 1 ELSE 0 END,
    0, 0, 0
  FROM ${ref("coc_member_hero_upgrades")}
  WHERE extracted_date BETWEEN DATE_SUB(DATE('${execution_ts}'), INTERVAL 7 DAY) AND DATE('${execution_ts}')

  UNION ALL

  SELECT
    ptag, 0, 0, 0, 0,
    CASE WHEN level_var > 0 THEN 1 ELSE 0 END,
    0, 0
  FROM ${ref("coc_member_spells_upgrades")}
  WHERE extracted_date BETWEEN DATE_SUB(DATE('${execution_ts}'), INTERVAL 7 DAY) AND DATE('${execution_ts}')

  UNION ALL

  SELECT
    ptag, 0, 0, 0, 0, 0,
    CASE WHEN level_var > 0 THEN 1 ELSE 0 END,
    0
  FROM ${ref("coc_member_troops_upgrades")}
  WHERE extracted_date BETWEEN DATE_SUB(DATE('${execution_ts}'), INTERVAL 7 DAY) AND DATE('${execution_ts}')

  UNION ALL

  SELECT
    ptag, 0, 0, 0, 0, 0, 0,
    CASE WHEN level_var > 0 THEN 1 ELSE 0 END
  FROM ${ref("coc_member_heroEquips_upgrades")}
  WHERE extracted_date BETWEEN DATE_SUB(DATE('${execution_ts}'), INTERVAL 7 DAY) AND DATE('${execution_ts}')
),

active_matrix AS (
  SELECT
    TIMESTAMP('${execution_ts}') AS generated_at,
    ptag,
    MAX(wars_active) AS wars_active,
    MAX(capital_active) AS capital_active,
    MAX(th_active) AS th_active,
    MAX(upgrade_hero) AS upgrade_hero,
    MAX(upgrade_spell) AS upgrade_spell,
    MAX(upgrade_troop) AS upgrade_troop,
    MAX(upgrade_heroEquip) AS upgrade_heroEquip
  FROM unified_metrics
  GROUP BY ptag
)

SELECT
  generated_at,
  ptag,
  wars_active,
  capital_active,
  th_active,
  upgrade_hero,
  upgrade_spell,
  upgrade_troop,
  upgrade_heroEquip,
  (wars_active + capital_active + th_active + upgrade_hero + upgrade_spell + upgrade_troop + upgrade_heroEquip) AS activity
FROM active_matrix
y para la tabla hot, tenemos:
config {
  type: "table",
  schema: "coc_gold",
  description: "Hot asset serving current active member snapshot by querying latest partition of clan_member_activity_historical using literal execution timestamp.",
  tags: ["gold", "daily", "activity", "hot"],
  bigquery: {
    labels: {
      environment: "production",
      domain: "clash-of-clans",
      layer: "gold"
    }
  },
  assertions: {
    uniqueKey: ["ptag"],
    nonNull: ["generated_at", "ptag", "activity"]
  },
  columns: {
    generated_at: "Snapshot generation timestamp of the current active partition.",
    ptag: "Unique player tag identifier.",
    wars_active: "Indicator (1/0) if player participated in war stars progression.",
    capital_active: "Indicator (1/0) if player contributed to clan capital.",
    th_active: "Indicator (1/0) if player upgraded town hall.",
    upgrade_hero: "Indicator (1/0) if player upgraded any hero.",
    upgrade_spell: "Indicator (1/0) if player upgraded any spell.",
    upgrade_troop: "Indicator (1/0) if player upgraded any troop.",
    upgrade_heroEquip: "Indicator (1/0) if player upgraded any hero equipment.",
    activity: "Aggregated activity score (0-7)."
  }
}

js {
  const execution_ts = dataform.projectConfig.vars.execution_timestamp || "2026-08-02T12:00:00Z";
}

SELECT
  generated_at,
  ptag,
  wars_active,
  capital_active,
  th_active,
  upgrade_hero,
  upgrade_spell,
  upgrade_troop,
  upgrade_heroEquip,
  activity
FROM
  ${ref("clan_member_activity_historical")}
WHERE
  generated_at = TIMESTAMP('${execution_ts}')
Es importante resaltar que:
- la primera definición es de tipo “incremental”, no obstante, la segunda es de tipo “table”.
- Solo la primera definición está particionada y clusterizada. La segunda no lo está porque vamos a recrear la tabla cada día y vamos a leerla completamente, por lo que será más ineficiente particionarla y clusterizarla, por cómo funciona el motor dremel de BigQuery por detrás.
¿Y la milla extra?
Cómo entendemos del negocio, pensamos en crear otra tabla con un resumen semanal para futuros análisis, esta se ve así:
config {
    type: "incremental",
    schema: "coc_gold",
    uniqueKey: ["week_start_date"],
    description: "Weekly performance aggregation of clan stats based on daily snapshots.",
    tags: ["gold", "daily"],
    bigquery: {
        labels: {
            environment: "production",
            domain: "clash-of-clans",
            layer: "gold"
        }
    },
    assertions: {
        uniqueKey: ["week_start_date"],
        nonNull: ["week_start_date"]
    },
    columns: {
        week_start_date: "The start date of the week (the Monday of that week).",
        week_num: "The week number of the year (starting Monday).",
        year: "The year of the weekly cohort.",
        last_date: "The latest snapshot date within this week.",
        first_date: "The earliest snapshot date within this week.",
        regs: "Number of snapshot records aggregated in this week.",
        w_ClanPoints: "Clan points recorded on the last_date of the week.",
        w_clanBuilderBasePoints: "Clan builder base points on the last_date.",
        w_clanCapitalPoints: "Clan capital points on the last_date.",
        w_warWins: "Total war wins on the last_date.",
        w_warTies: "Total war ties on the last_date.",
        w_warLosses: "Total war losses on the last_date.",
        w_members: "Number of members in the clan on the last_date."
    }
}

WITH cohortes_semanales AS (
    SELECT
        DATE_TRUNC(extracted_date, WEEK(MONDAY)) AS week_start_date,
        MAX(extracted_date) AS last_date,
        MIN(extracted_date) AS first_date,
        COUNT(*) AS regs,
        ARRAY_AGG(
            STRUCT(
                clanPoints AS w_ClanPoints,
                clanBuilderBasePoints AS w_clanBuilderBasePoints,
                clanCapitalPoints AS w_clanCapitalPoints,
                warWins AS w_warWins,
                warTies AS w_warTies,
                warLosses AS w_warLosses,
                members AS w_members
            )
            ORDER BY extracted_date DESC
            LIMIT 1
        )[OFFSET(0)] AS latest_stats
    FROM ${ref("clan_description")}
    ${when(incremental(),
        `WHERE extracted_date >= DATE_TRUNC(DATE_SUB(CURRENT_DATE(), INTERVAL 7 DAY), WEEK(MONDAY))`
    )}
    GROUP BY 1
)
SELECT
    week_start_date,
    EXTRACT(WEEK(MONDAY) FROM week_start_date) AS week_num,
    EXTRACT(YEAR FROM week_start_date) AS year,
    last_date,
    first_date,
    regs,
    latest_stats.w_ClanPoints,
    latest_stats.w_clanBuilderBasePoints,
    latest_stats.w_clanCapitalPoints,
    latest_stats.w_warWins,
    latest_stats.w_warTies,
    latest_stats.w_warLosses,
    latest_stats.w_members
FROM cohortes_semanales
Con estas tablas estamos listos para crear un dashboard en Data Studio (Antes Looker Studio).
Tablas resultado y Data Studio
Las tablas resultado se ven así:
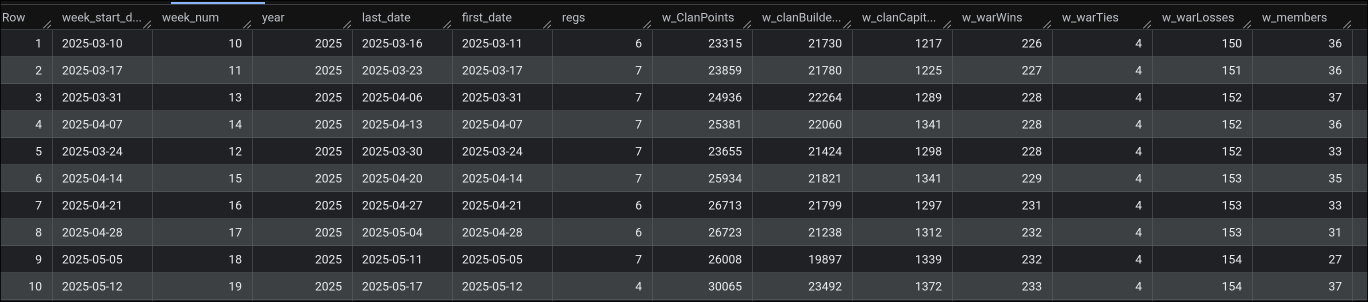
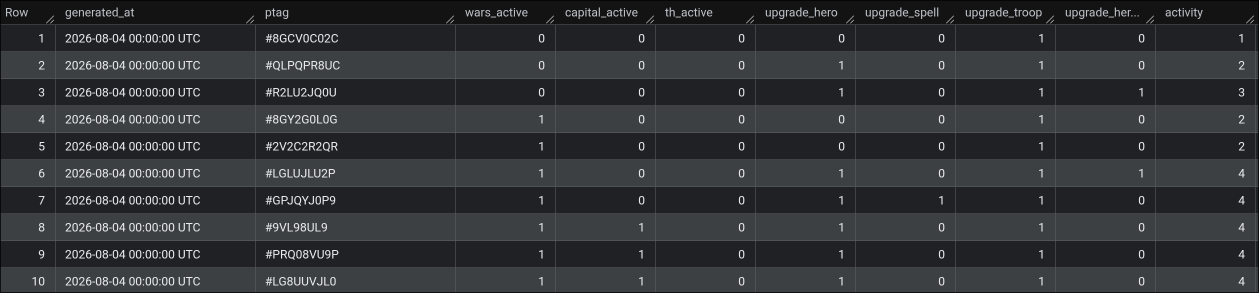
Están listas para cargarse y servirán para construir el siguiente dashboard.
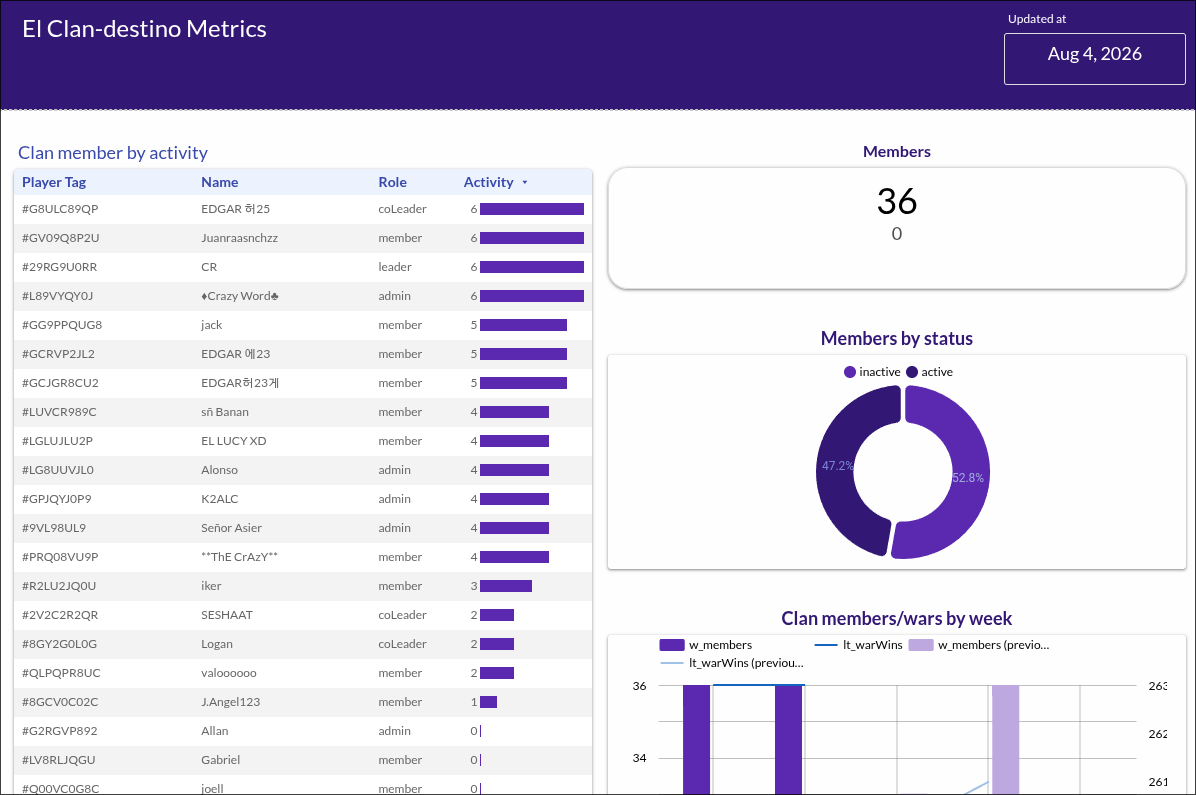
Este dashboard pueden verlo actualizarse cada día en Looker Studio
Conclusión
Este es un resumen de la implementación, el proyecto completo se encuentra en [link_repo]. Ahora, que ya lo tenemos corriendo en producción dedicaré blogs posteriores a explicar buenas prácticas y decisiones de arquitectura, pero primero es necesario darles el panorama general.