Reflexiones y consideraciones en la implementación de un flujo de datos ELT
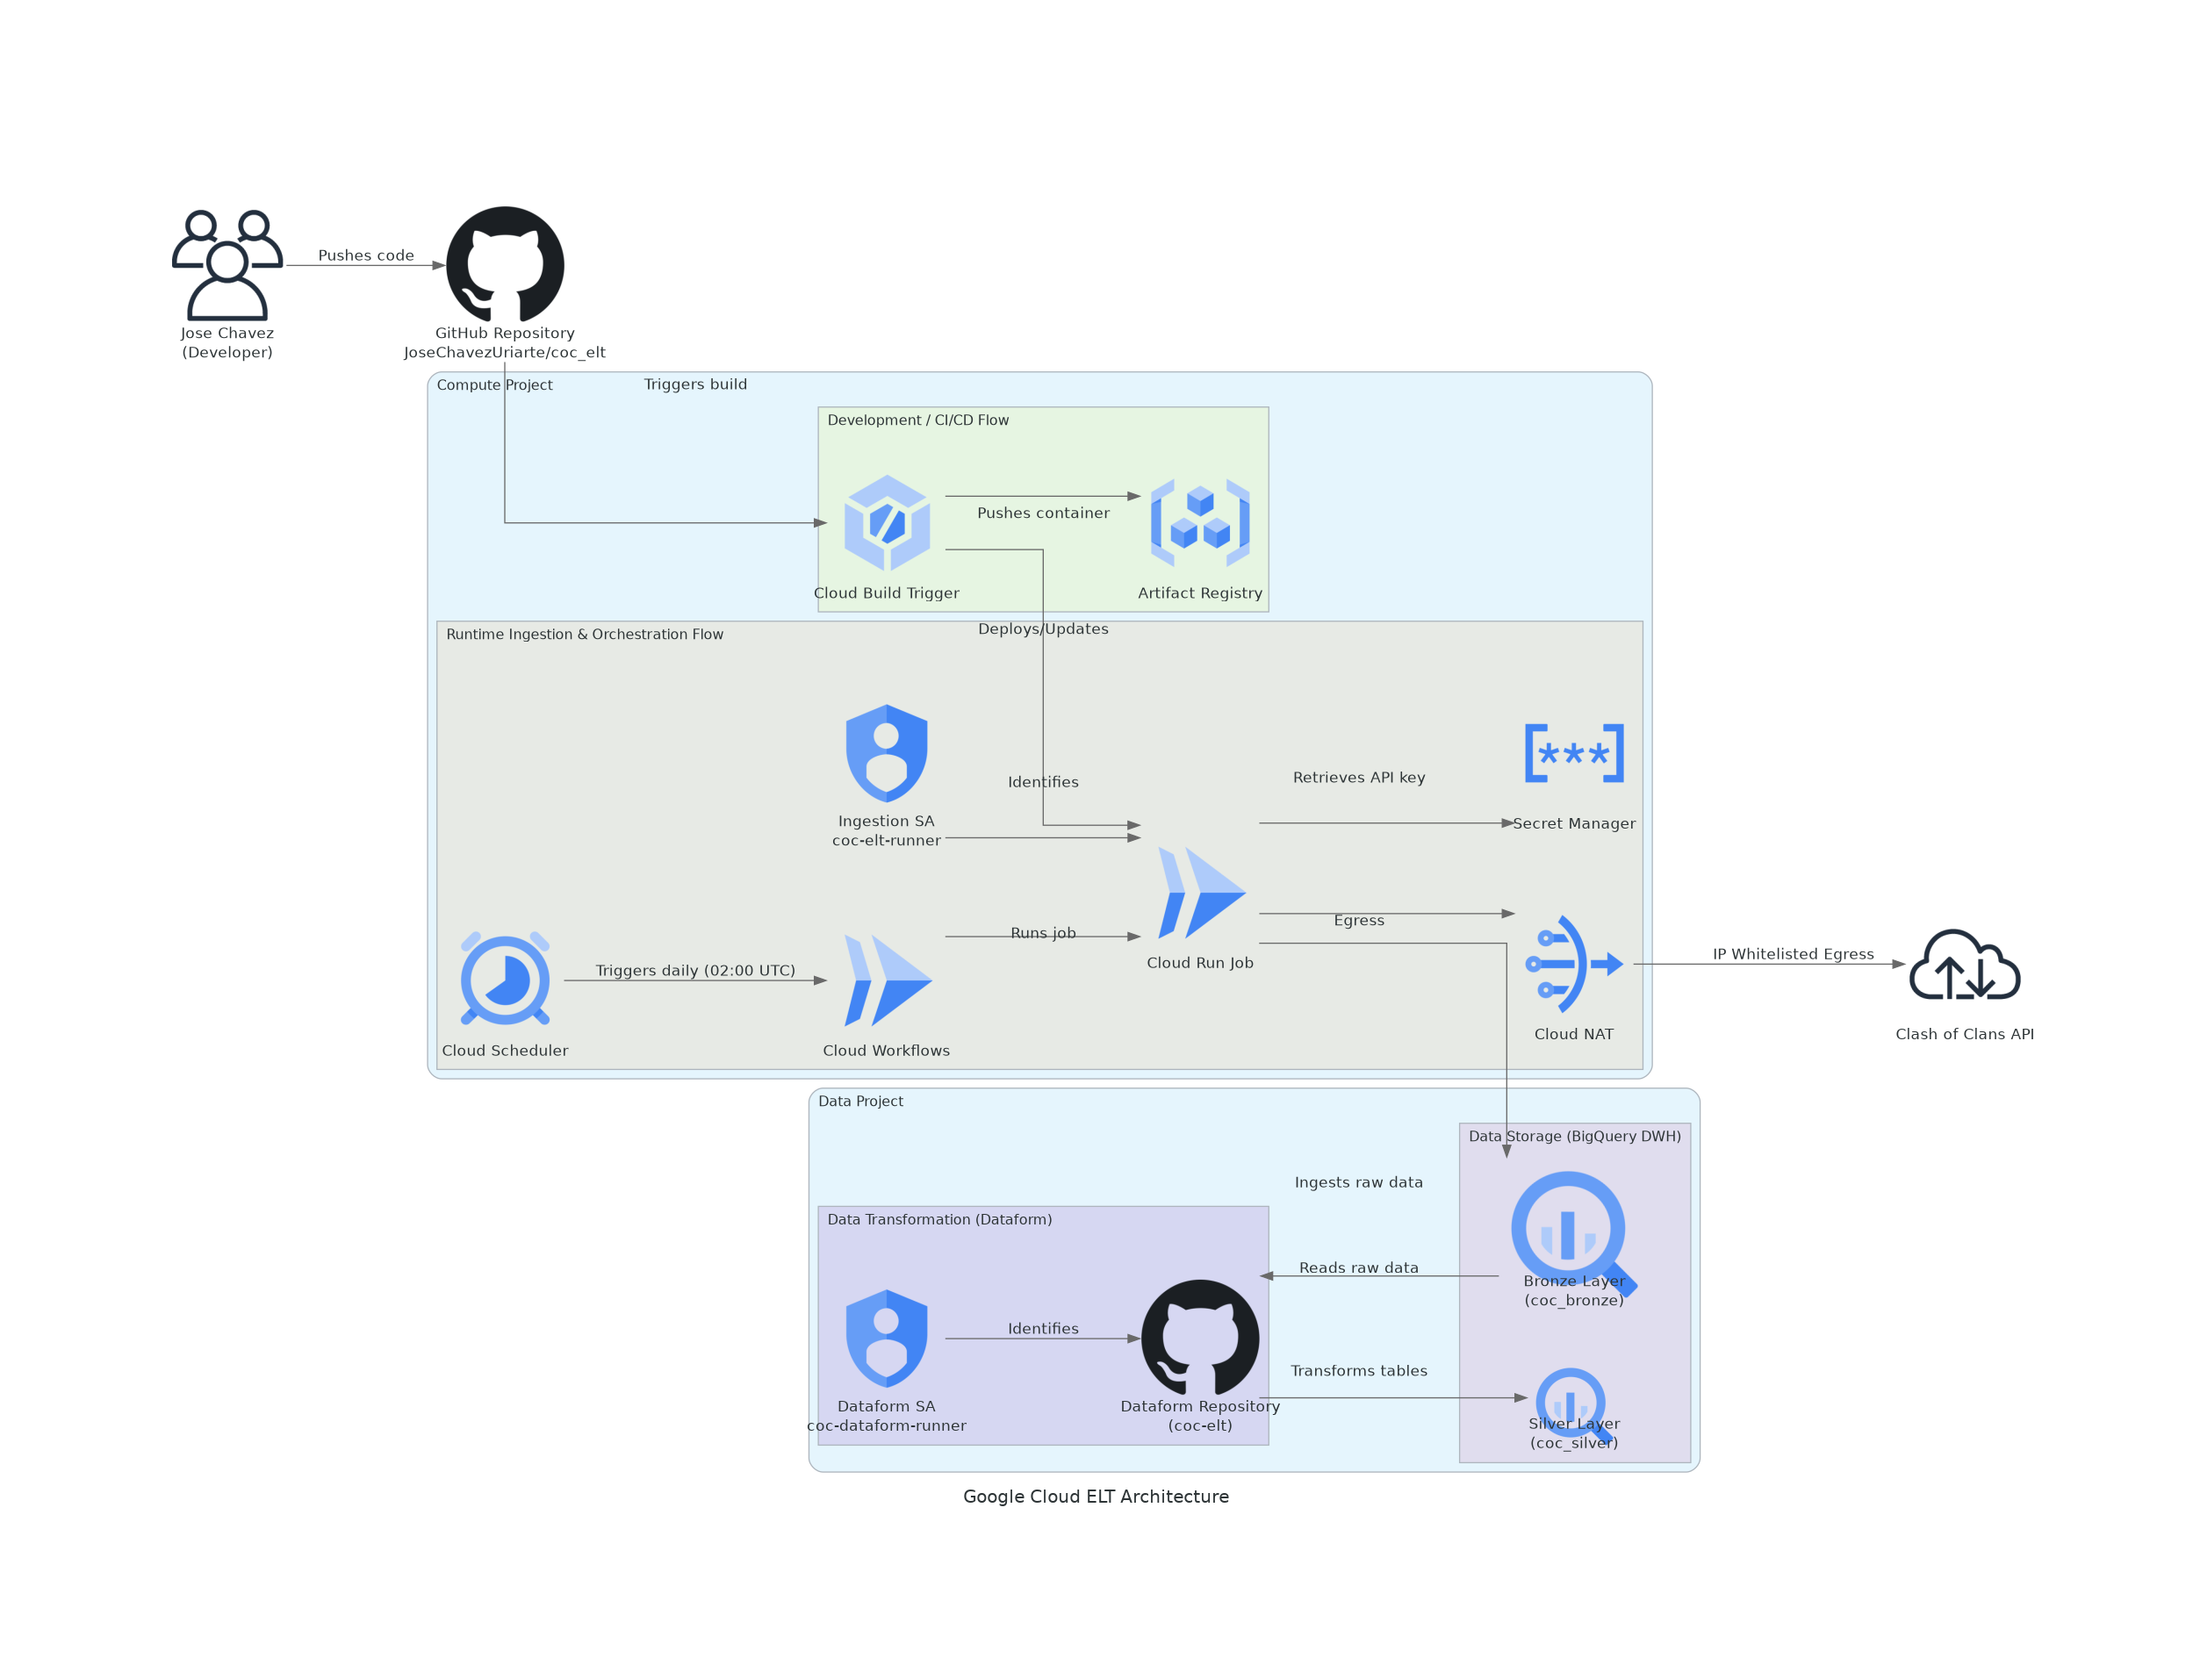
Este es un proyecto de principio a fin para implementar un proceso ELT listo para producción. Implementamos una arquitectura medallón, almacenando la información en diferentes estados: crudo (bronce), desnormalizado (plata) y agregado (oro).
Durante los tres capítulos precedentes realizamos una implementación práctica, pero quiero detenerme a matizar algunos aspectos que considero fundamentales.
El Problema
Todos los flujos de extracción de datos buscan resolver un problema, que generalmente está formulado como una o varias preguntas. Esta pregunta puede estar en diferentes ámbitos: negocios, ciencia, política, economía, etc.
Antes de empezar siquiera a bocetar cualquier flujo de datos, hay que asegurarnos de entender el problema. En el caso del proyecto en cuestión, estamos resolviendo un problema de gestión. Y si bien al enfocarlo en un videojuego puede parecer trivial, me ayuda a realizar parangones con el mundo corporativo real.
En nuestro caso particular, tenemos un líder de clan que desea saber quiénes están apoyando al crecimiento del clan. Para esto, el líder definió un criterio de actividad. Esencialmente busca responder a la pregunta “¿Qué miembros son activos?” para poder posteriormente “gestionar ascensos o expulsiones”. Una vez aclarado este punto, podemos empezar a pensar en la estrategia para crear el flujo de datos.
Entendamos las fuentes
- Las fuentes de datos y sus características. - ¿Tenemos documentación de las fuentes? ¿Son fuentes de datos estructuradas, semiestructuradas o no estructuradas? ¿Cómo vamos a procesarlas?
- El volumen de información. - ¿Cuántos registros generaremos al día en promedio?
- La frecuencia de actualización. - ¿Cada cuánto se generan nuevos datos?
Con estas variables en mente podemos determinar para este proyecto:
- Los datos vienen en un formato JSON semiestructurado, pues consumimos una API.
- El volumen de información depende de la dimensión, siendo la dimensión de tropas por jugador la que contiene mayor granularidad.
- Siempre que se consulta la API se consulta el “estado actual”; no obstante, este no varía frecuentemente, por lo que podemos consumirlo diariamente. Así, no gastamos de más en cómputo y tampoco renunciamos a la información.
Herramientas
Debemos entender qué herramientas tenemos a disposición y cuáles son las más adecuadas. Tenemos infinidad de alternativas en el ecosistema de Google Cloud (o en otras soluciones de cloud). Ahora que entendemos las fuentes podemos determinar la arquitectura del flujo de datos:
- Cloud Run (trabajo) para extraer la información diariamente.
- Cloud NAT para enlazar la API con nuestra IP estática.
- Workflows para orquestar todo el flujo en un solo lugar.
- Dataform para versionar, añadir metadata y gestionar nuestras transformaciones de datos.
- BigQuery para almacenar la información siguiendo una arquitectura medallón.
- Data Studio para reportar la información, respondiendo a la pregunta de negocio.
Buenas prácticas en general
- Aplicación del principio de mínimo privilegio utilizando cuentas de servicio.
- Utilizar Terraform aplicando Infraestructura como Código (IaC).
- Crear VPC personalizada delimitando las subredes.
- Añadir metadatos a las definiciones de Dataform.
- Gestión de credenciales utilizando Secret Manager.
Resumen
Logramos un flujo de datos resiliente para responder preguntas de negocio, desplegamos la información en Data Studio para que las partes interesadas tengan diariamente el reporte del desempeño semanal y puedan gestionar en base a este.
Revisa los capítulos anteriores
Esta publicación es la cuarta parte de la serie sobre construcción de un flujo de datos de grado empresarial. Si aún no has leído las entradas anteriores, te recomiendo revisarlas en orden:
- Cómo crear un pipeline ELT robusto - Ingesta de datos y capa Bronce.
- Transformación de datos: estructuremos los datos con Dataform - Limpieza y modelado incremental en la capa Silver.
- Rastreo de Actividad en Clash of Clans con Dataform y BigQuery - Creación de métricas y agregaciones en la capa Gold.